这行注释下面,紧跟着一句干脆利落的返回:Connection OK。
八月里我重新克隆 Snaply 的仓库,在配置管理的代码里撞见它,愣了两秒,然后笑出了声。这是我一月份自己写的。当时为了先把设置页那个复古弹窗调漂亮,随手塞了一行假返回,弹窗调好了,这茬也就彻底忘了。半年来,配置页上弹出的那句绿色“连接成功”,一直是我写给自己的安慰剂。
这篇就从这行注释开始,把 Snaply 上传按钮背后的账,一笔笔算一遍。
一月的那身皮囊
做 Snaply 是在寒假刚开始的那几天。那会儿我整个人都扑在它的外壳上:带着浓重 Windows 98/2000 味道的灰白窗口,利落的直角按钮,故意调出颗粒感的像素边框,还有一个把上传过程实时打印成终端绿字的交互页。
写得兴起,本地一口气攒了 41 个文件、将近七千行代码,2026 年 1 月 19 日推上仓库,接下来两天又连着提交了五次,停在 0cfe595。看着浏览器里灰白相间的窗口和跳动的绿色字符,那几天我心里别提多得意了。
直到半年后再打开这个仓库,怀旧的新鲜劲儿早过了,眼睛才终于越过外壳,落到了“上传”按钮后面。一张图顺顺当当出现在画廊网格里,充其量只是浏览器里结出的一个表面果子;文件到底落在哪块盘上,元数据写全了没有,异步的打标任务有没有半路夭折,按一下刷新还能不能把图原样找回来——这些才是一个图床要算清的细账。
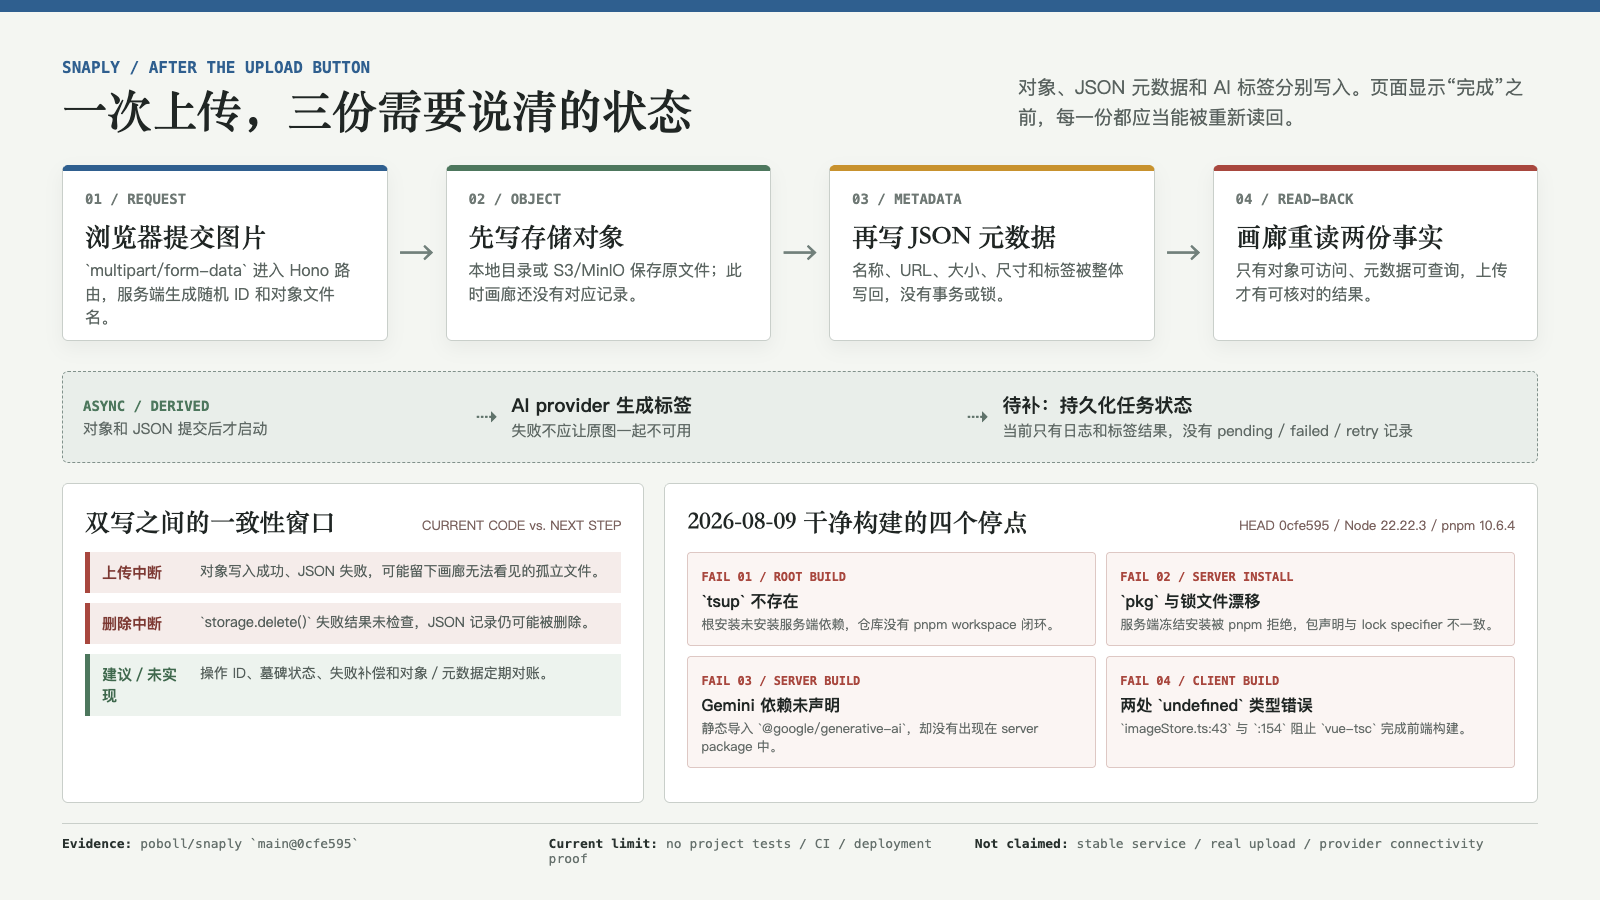
Snaply 上传后的状态链路:对象、JSON 元数据与 AI 标签分开处理,下方列出一致性窗口和当前构建失败。
图:顺着提交 0cfe595 与 2026-08-09 本地重装复测整理的上传状态链路图。红色项是当时落下的缺口,绿色项则是接下来打算补齐的方向。
一张图片,两份状态
Snaply 的服务端用的是轻巧的 Hono。路由收到前端传来的 multipart/form-data 后,先给文件生成一个随机 ID,调存储适配器把二进制对象存好,再用 Sharp 读出图片的真实宽高,最后把文件名、访问 URL、体积、日期、尺寸和初始标签一起写进本地的 JSON 文件。看着是一次上传,系统里其实劈出了两份互相独立的状态:一份是存储后端里的实体对象,一份是画廊用来渲染和检索的元数据。
把实体文件和元数据拆开存,当时确实省了配数据库的麻烦,但也埋下了两个方向完全相反的一致性隐患。上传时,图片对象已经稳稳写进存储,紧接着 JSON 落盘却因为权限或 IO 异常摔了一跤,存储桶里就会多出一个画廊根本不知道的孤儿文件;删除时更离谱,路由调了 storage.delete(),却压根没去检查它返回的布尔值,转头就把 JSON 里那行记录抹掉向前端报喜——也就是说,底层对象哪怕根本没删掉,画廊也会高高兴兴地当它已经清理干净了。
轻量的本地文件方案不是不能用,只是既然存在双写,就得给半路崴脚的操作留个善后的地方。比如上传入口先发一个稳定的操作 ID,等存储对象落定后再写元数据;第二步没落盘,就顺着同一个 ID 把刚写的对象删掉,或者记进一张待对账列表。删除时先在元数据里打个“墓碑”标记,等存储端实打实确认销毁了,再回头把记录彻底抹去;平时再配一个定期比对存储对象列表和 JSON 元数据的巡检脚本,漏网的孤儿文件也能被揪出来。在 0cfe595 那版急着跑通主流程的代码里,这些兜底逻辑一行都没有。
再往下看读写,当时的 Database 类把整个图片数组一次性读进内存,之后不管是新增、改标签还是删除,都是调 writeFile 把整份 JSON 从头到尾覆盖写回。
一个只给自己用、上传不频繁、单进程跑的桌面小玩具,这样做有它的痛快:不用维护数据库,拿文本编辑器打开 JSON,家当一览无余。可一放到并发或多实例下,没有文件锁、没有事务、没有版本号校验、没有原子替换的短板就全露了出来——两个请求前后脚改了数组,后一次全量写回就会把前一次的改动直接抹平。
而且这份 JSON 只在进程启动时从磁盘读一次,之后所有增删改查都在内存数组里打转。要是另一个进程,或者我自己写的运维脚本在外面改了磁盘上的 JSON,跑着的服务端一无所知。以后就算还想保留纯文件存储的轻快,也得把两件事分开办:一是“先写临时文件、刷盘、再原子重命名替换”的落盘安全,二是怎么感知并合并外部改动。
“兼容 S3”,也有前提
为了不把图床绑死在服务器本地硬盘上,仓库里抽了一个 StorageAdapter 接口,让本地目录、S3、MinIO 都挂在同一条上传路由下面。
接口虽然拆开了,各家对象存储的脾气却没那么容易抹平。现在的 S3 适配器把访问方式硬编码成了 path-style,每次上传还固定塞一个 ACL: public-read 头。可真实的云环境里,不少兼容 S3 的后端压根不支持对象级 ACL,很多部署环境也更习惯用桶策略、CDN 回源鉴权或带有效期的签名 URL 来管访问。长着同一副 S3 的模样,背后的公开访问策略却没法一套参数走天下。
元数据里存的是一条拼好的完整 URL。列表路由往外吐数据时,代码直接截 URL 末尾那一段当文件名,再按当前配置重新拼出展示地址。换个域名、改个路径前缀,这招都能应付;但它默认了一个很脆的前提:URL 的最后一段永远等于存储里的对象键(Object Key)。更经得起折腾的做法,是把存储类型、bucket 名、完整的 object key 这些不随展示方式变化的硬标识存进元数据,给浏览器看的 URL 按当前配置现算。哪天要换 CDN、调目录层级,就不用拿着旧 URL 倒推文件当年存在哪儿了。
然后就是开头那一幕。POST /api/config/test 路由上方挂着那行 TODO: 实际测试 S3/MinIO 连接,下面直接返回 Connection OK。不解析 DNS,不核对密钥签名,也不往桶里探一下最小读写权限;配置页上弹出的绿色成功提示,不过是我写给自己的安慰剂。
类似的裂缝,“批量重新打标”里也有。那段逻辑遍历旧图时,直接调 storage.get(filename) 把原图字节读回来喂给 AI。可翻遍 StorageAdapter 的接口定义,压根没声明过 get;S3 的实现类里自然没有,只有本地文件存储顺手多写了一个读取实现。偏偏路由里接存储实例的参数被我随手标成了 any,本该在构建阶段吹哨报警的 TypeScript 编译器,就这么被糊弄过去了。
下拉菜单里能选好几种存储后端,绝不等于每个按钮都把这几种后端老老实实兼容了一遍。这个教训,我是被自己的 any 上的课。
开关能拨,不代表有人在听
早先写项目说明时,我凭着脑子里的设想,把 WebP 自动转换、缩略图生成和上传体积限制,统统写成了已经落地的功能。
这次对着 0cfe595 从头捋一遍,脸有点发烫:convertToWebp、webpQuality、generateThumbnail、thumbnailSize、maxFileSize 这几个看着有模有样的参数,只活在配置对象的类型声明、默认值和前端设置页的表单控件里。真正干活的上传路由,从头到尾连读都没读过它们一眼。
引入的图像处理库 Sharp,在代码里干的活其实很少。一处是入库前读原图宽高;另一处是待识别的图片超过 2 MB、要发给 AI 打标时,在内存里临时压一份最大边长不超过 1024×1024、质量 80 的 JPEG 缓冲。这份 buffer 只是给大模型请求减负,用完就扔,真正写进存储的依然是原图。设置页上的开关能拨、点保存能写进配置文件,只说明表单持久化这条路通了;数据流真按开关的意思去干活,中间还差着实打实的处理逻辑。
AI 标签,是上传之后的事
上传路由的编排里,有一处当时写得还算克制:等图片对象和 JSON 元数据都落盘了,才在后台异步去调 AI 接口生成标签。
这个先后顺序守住了一条底线。远端大模型超时也好,抽风吐回一堆解析不了的乱码也好,原图已经稳稳成了一条有效记录,标签可以等会儿重试,或者我自己手写补上。自动打标只是派生加工,没道理因为一句标签没算出来,就连累原图一起失败。
问题在善后。现在这套异步流程几乎全靠控制台日志:成功了,悄悄更新内存数组里的记录;失败了,终端里吐一行红字了事。元数据里没有 pending、failed 这样的状态字段,也不记尝试次数和最近一次报错原因。于是刷新画廊,看见某张图底下空空的一个标签都没有,你根本分不清它是还在排队等 AI,还是早就失败歇菜了,还是本来就没开打标。把派生任务的状态和带上限的重试计数写进元数据,上传主链路照样轻快,每一次后台失败也都有迹可循。
AI 适配层里,Ollama、Gemini、通义、智谱、硅基流动五个分支排得整整齐齐。其实当时我只是把五种拼请求体的代码一股脑写了进去,并没有挨个跑通。有个细节特别扎眼:服务端文件最顶上静态导入了 @google/generative-ai,可 server/package.json 的依赖里根本没声明这个包。结果就是,哪怕配置里压根不打算用 Gemini,在全新环境里构建,服务端也会因为找不到模块当场停摆。没补齐连通性验证、超时熔断、失败状态回写和回归测试之前,“支持五种 AI 模型”说白了只是一份心愿单。
还有一件一月份完全没操心过的事:我只在自己电脑上跑本地实例,没想过权限隔离。哪天真挂到公网上、又切到云端的模型服务商,上传的私人图片就会被编码发往远端接口。真要往公网走,接口鉴权、读取配置时的密钥脱敏、允许前端修改的字段白名单、凭据的加密落盘,都得一起补上。
弹绿框之前,先读回来
前端还藏着一个我当时专门用来“后端没起来也能看界面”的小把戏,叫“离线模式”。
接口一请求不通,前端就用浏览器的 FileReader 把选中的图片转成一长串 Data URL,直接塞进 Pinia 的内存状态里。画廊确实能在当前标签页里热热闹闹地把图渲染出来,右上角还煞有介事地挂着一个 LocalStorage Fallback 徽标。可顺着源码找下去,这串数据从头到尾没往 localStorage、IndexedDB 或者本地文件系统里写过一个字节。手一滑按了刷新,刚传的图瞬间无影无踪。名字听着很让人放心,干的其实只是“当前页面的临时预览”。(给自己的代码起名字也能这么会忽悠,我也是服了一月份的自己。)
前端的 API 封装也把几种完全不同的失败揉成了一团。拉列表和上传的函数拿到响应后,没先核对 HTTP 状态码和业务层的 success 标志。服务端返回的 JSON 能正常解析、偏偏缺了 data 字段时,一句 data || [] 就悄无声息地兜成空数组,调用方分不清是画廊本来就空,还是服务端拒绝了请求。响应连合法 JSON 都不是的时候,res.json() 直接抛异常:列表加载函数接住它,一头扎进“离线模式”;上传路径则把错误一路往外抛,不会落回空数组。这两种走向,本该在状态流里分得清清楚楚。
所以,我给接下来的上传流程立了一条更踏实的规矩:上传接口返回成功后,前端先别急着弹绿框,而是拿服务端刚返回的图片 ID 再调一次元数据读取接口,顺带对返回的图片 URL 做一次轻量的存在性探测。这替代不了真正的底层事务,但至少在告诉用户“上传成功”之前,亲手确认过一回:实体对象和元数据,都能从服务端原样读回来。哪边没读回来,页面就老老实实把这次操作的 ID 和卡在哪一步留在屏幕上,而不是退回一个岁月静好的空画廊。
一次干净构建,没过
2026 年 8 月 9 日下午,我想看看这份半年前的代码离开当初那个装满缓存的旧目录还站不站得住,就把远端 HEAD 克隆到一个空文件夹,在 Node 22.22.3、pnpm 10.6.4 下从零构建一次。
根目录用冻结锁文件(Frozen Lockfile)安装,进度条顺顺当当走完。接着跑全量构建,服务端那步立刻报错:找不到打包工具 tsup,顺带提示它自己目录下的 node_modules 根本不存在。我一拍脑门——一月份建仓库时,根目录压根没放 pnpm-workspace.yaml,在根目录敲的安装命令,自然没把 server 子目录当成工作区的一员带上。
那就切进 server 单独装。冻结锁文件安装,pnpm 当场罢工:package.json 里的 pkg 依赖声明和锁文件对不上。放宽锁文件限制硬装上之后,打包又一头撞上前面那个坑——缺了没声明的 @google/generative-ai。再去试前端的独立构建,也没能全身而退:imageStore.ts 里有两处可能取到 undefined 的对象访问,被 TypeScript 严格模式当场拦下。
满屏红字,我对着屏幕苦笑。一月份我本地目录里早就零零散散装过全局或缓存依赖,开发服务器一跑顺风顺水,我就兴冲冲打了个 v0.0.1 的 Release 标签。编译好的包没往附件里传,补部署说明的那次提交甚至落在了标签之后;没有自动化测试,也没挂 GitHub Actions。自己关起门来跑得通,和别人克隆下来能一键构建通过,中间隔着好几道实打实的门槛。
一个拿得出手的 Release,至少得指明对应哪个确切提交,能靠冻结锁文件把前后端从头构建通过;要是还提供二进制或容器镜像,构建产物的哈希值和最基本的启动探活也一样不能少。README 里的功能列表写的是当时脑子里的蓝图,跑得通的构建脚本,才算真把东西交到了别人手里。
下次先修什么
账算到这儿,下回腾出周末改这个仓库的顺序,也就不用纠结了。
先把地基垫平。 不加任何新花样:统一根目录的工作区配置和安装路径,同步服务端那份脱节的锁文件;那个悬空的 Gemini 导入,要么正式补进依赖,要么从代码里摘掉;顺手修掉前端状态库里那两处类型隐患。基于冻结锁文件的全量构建能一口气跑通了,后面的修补才有块踩得住脚的平地。
再补存储层的缺口。 让配置页的连接测试真去发一次最小权限探测;给 StorageAdapter 补上统一的读取方法,让批量重新打标不再靠运气;把双写和删除时半路失败的兜底写进代码;给 JSON 并发写入和 AI 打标失败补上正经的测试。真打算挂公网的话,接口认证、配置返回时的密钥脱敏、存储桶访问策略,都得赶在写部署教程之前落地。
至于 WebP 转换、缩略图裁剪、接更多大模型、发新 Release,都往后排一排。
把终端里的报错日志收进备忘录的时候,我发现下一轮维护要回答的,依然是最初那几个朴素得不能再朴素的问题:传上去的文件对象到底写到了哪里?配对的元数据有没有稳稳落盘?后台的派生任务跑完没有?万一中间哪一步崴了脚,系统该从哪一层把状态找回来?
只有当这几个问题在代码里都有了踏实的着落,复古窗口里跳出的那句绿色“上传完成”,才算既没骗人,也真正配得上那份怀旧的质感。